
Droid:构建前沿智能体工具链
Droid:构建前沿智能体工具链
为 Factory 企业级智能体打造的全新引擎,专为复杂项目与日常开发而设计。 发布日期:2026年10月29日 · 作者:Factory 研究团队
原文:https://factory.com/news/frontier-harness
过去一年,我们与全球一些最大型企业的数十万名开发者携手合作。在与这些团队并肩工作的过程中,我们构建并打磨了一套前沿智能体工具链(Agent Harness),直接满足企业开发的核心需求:在复杂任务上交付高质量成果、高效利用计算资源,并具备强大的安全管控能力。
今天,我们正式推出 Droid 1.0:凭借全新的设计原则和程序化工具调用(Programmatic Tool-Calling)引擎,它比以往任何时候都更精准、更高效、更快速。
Droid 是我们的智能体工具链。智能体工具链涵盖了模型周围的一切:提示词、工具集、工具执行结果的返回方式,以及驱动这一切运转的主循环。如今,智能体可以连续工作数小时甚至数天,跨越数百轮交互,而每一轮交互都会重新发送指令、工具定义和历史记录。
今天对 Droid 的更新是迄今为止规模最大的一次。在相同的任务上,Droid 比为特定模型量身打造的原生工具链效率高出最多 20%。它同时也为未来的工作范式做好了准备:当前沿模型能够将整个工作流规划为代码时,Droid 可支持它们在单次模型请求中执行数百次工具调用。
Factory 在设计上天然保持模型无关(Model-Independent)。我们坚信,最优秀的智能体工具链应当为每一种模型而构建,使用户既能自由选择市场上最顶尖的模型,也能让 Droid 通过自动模型路由器 Factory Router 挑选最高效的模型组合。
为多种模型协同优化工具链,反过来会让工具链本身更加扎实。当你只针对单一模型进行调优时,很难分清哪些是真正的架构进步,哪些只是对特定模型怪癖的妥协适应。跨模型研发确保了最核心的改进具备通用泛化能力,并在最初启发这些改进的模型之外依然稳固有效。
这就是我们内部 Agent Factory 背后的核心理念。智能体会同时分析基准测试中的失败案例与用户在实际会话中遇到的摩擦点,提出改进草案,并在受影响的每一个模型家族上逐一开展测试。最后由我们的工程师审查实测证据,决定哪些改动最终上线。
由此诞生的便是市场上最高效的企业级编码智能体,它针对每一款前沿模型(无论开源权重还是闭源模型)都完成了深度调优。
本文将详细介绍正面对决的评测结果、工具链背后的设计原则、内部 Agent Factory 的构建方法,以及带来最大性能突破的核心架构变更。
01 市场上最高效的工具链
在相同的任务中使用相同的底层模型,Droid 的得分高于我们测试过的所有其他工具链,同时单任务成本更低。
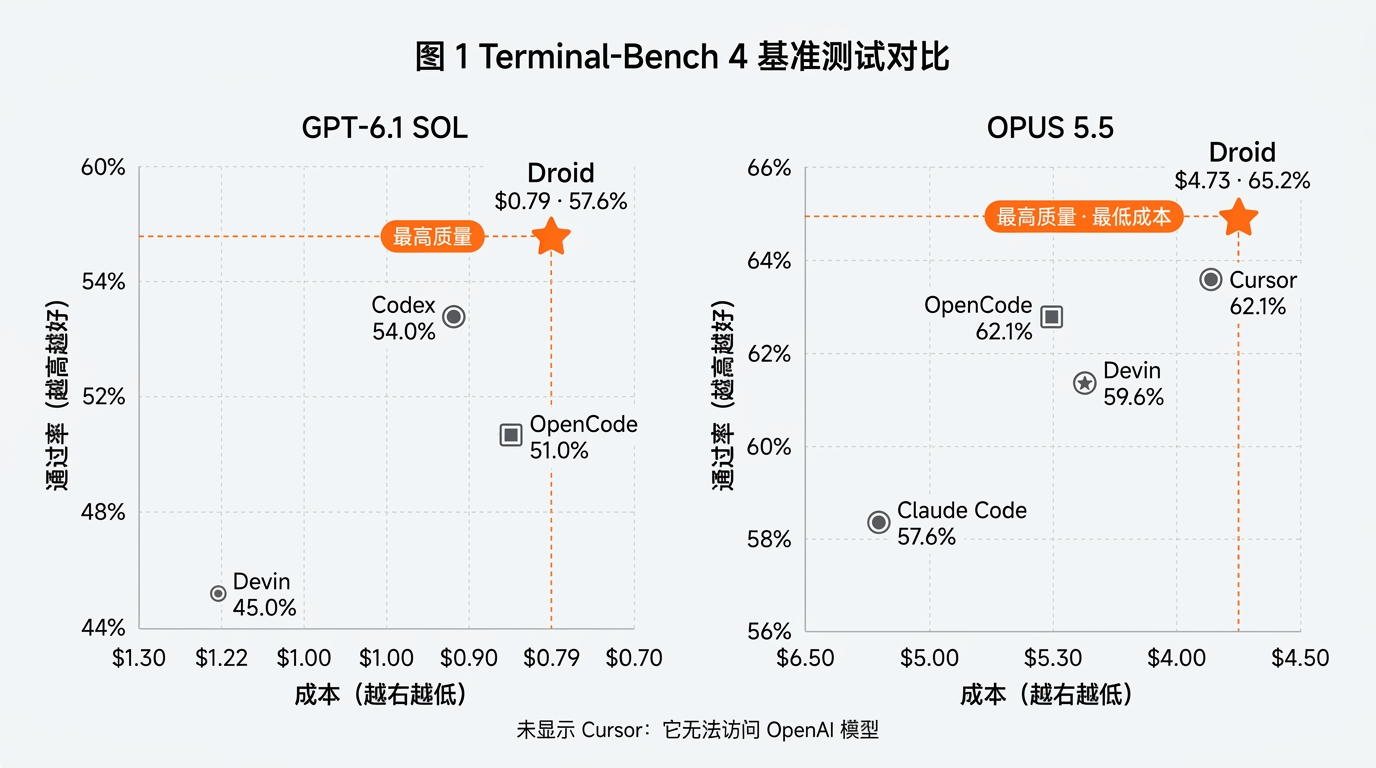
图 1:Terminal-Bench 4 基准测试结果
- GPT-6.1 Sol:Droid 的得分(57.6%,单任务成本 $0.79)比 Codex(54.0%)高出 3.5 个百分点,且成本降低 12%;比 OpenCode(51.0%)和 Devin(45.0%)高出 6.6 至 12.6 个百分点。(注:图中未显示 Cursor,因为它无法访问 OpenAI 模型。)
- Claude Opus 5.5:Droid 的得分(65.2%,单任务成本 $4.73)比 Cursor(62.1%)、OpenCode(62.1%)、Devin(59.6%)和 Claude Code(57.6%)高出 3.0 至 7.6 个百分点,且成本最高降低 24%。
随着智能体运行时间的拉长,这一差距会愈发关键。在跨越数百个步骤的长任务中,更优秀的智能体犯错更少,能为后续步骤奠定更可靠的基础;而成本更低的智能体则能让你在相同预算下并行运行更多实例。Droid 会针对其支持的每个模型单独优化提示词、工具描述和工具调用模式,因此所有受支持的模型都能享受到这些增益(包括使用自有 API 密钥 BYOK 的场景)。
促成上述评测结果的最大架构变更,是让模型能够从程序代码中调用工具。
02 程序化工具调用 (Programmatic Tool Calling)
在标准的智能体循环中,模型直接调用工具,每次工具输出都会被直接追加到模型的上下文中。**程序化工具调用(PTC)**则采用截然不同的方式处理长周期任务:智能体通过编写一段程序来调用工具。
借助 PTC,智能体可以预先进行全局推理,编写出完整的工具调用工作流代码,随后在单次调用中端到端地执行整个程序。例如,它可以编写一段工作流来遍历读取数百个文件并筛选出提及特定主题的少数文件、对数十个 Linear 工单进行批量分类,或者按照确定性流程分步执行复杂的数据库迁移。
CodeAct(Wang 等人,2024)的研究表明,通过代码执行动作在 17 款模型上均优于 JSON 和纯文本工具调用。Cloudflare 和 Anthropic 于 2025 年底将该理念引入生产环境,而 Codex 则在今年将其带到了编码智能体领域。
我们在 Droid 1.0 中将 PTC 设为默认模式,主要基于以下三个原因:
- 保持上下文窗口干净:模型接收到的仅仅是其程序的最终打印输出,普通的中间工具输出(原始文件、搜索结果、长日志)作为变量保留在程序内部。
- 大幅减少模型请求次数:单个程序即可完成多次工具调用,使复杂任务的执行速度更快、成本更低。
- 提升智能体可靠性:检查逻辑和循环控制以确定性的代码方式运行,彻底消除了模型在中途“偷懒”或遗漏原定计划分支的可能性。
2.1 脚本模式 (Script Mode)
Droid 将 PTC 实现为一项名为 Script 的工具。模型编写 JavaScript 代码,在本身没有独立文件系统、网络或系统访问权限的安全沙箱中运行。
单个 Script 可以在一次模型请求中发起数百次工具调用,因此系统指令和对话历史只需发送一次,无需每隔几次调用就重复发送。打印输出的大小设有上限,完整结果会记录在日志中供模型后续按需检索。彼此无依赖关系的调用会并发执行,因此整批调用的耗时仅取决于其中最慢的那一次调用。
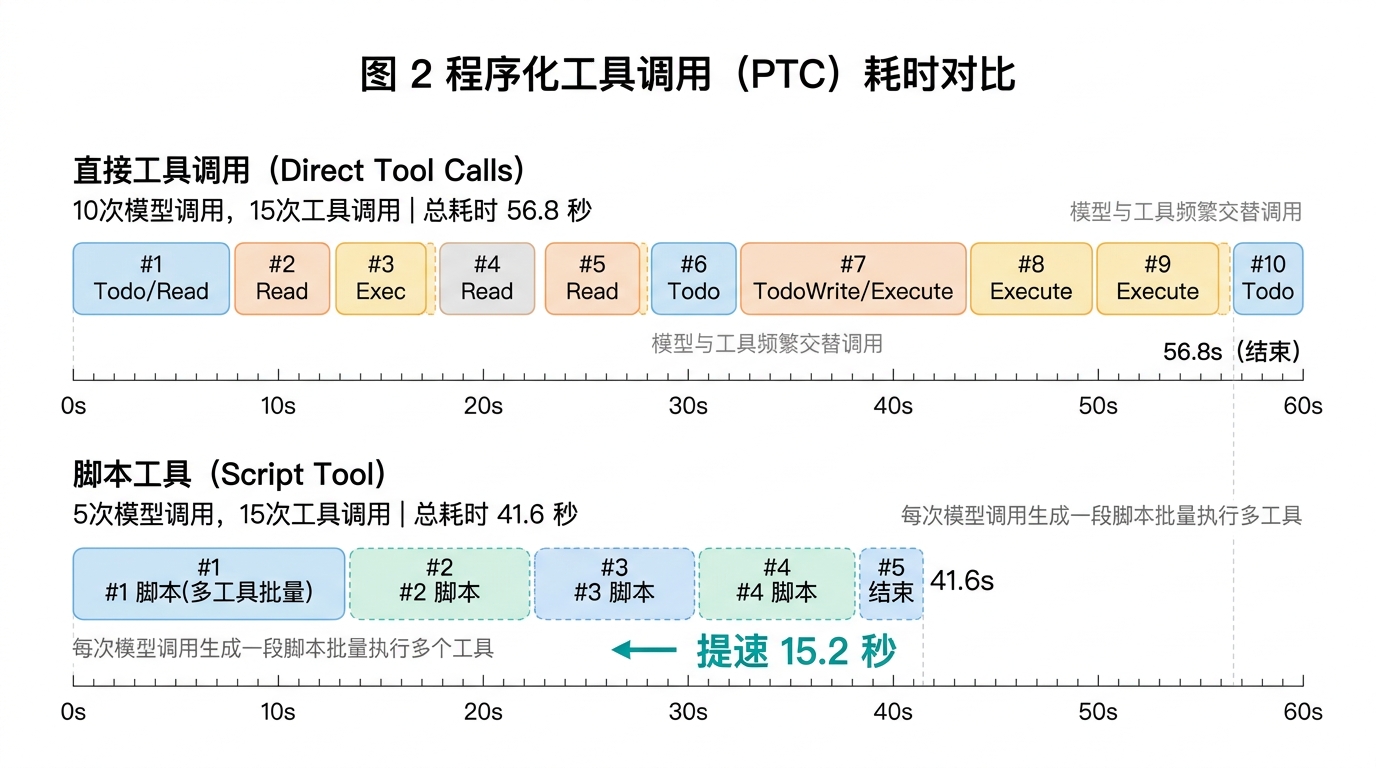
图 2:程序化工具调用与直接调用对比(基于 GPT-6.1 Sol 高推理模式修复失败单元测试的常见会话回放)
- 直接工具调用(Direct Tool Calls):每执行 1 到 2 次工具调用就需要重新请求一次模型。总计 10 次模型调用、15 次工具调用,模型推理耗时 42.3 秒,总耗时 56.8 秒。
- 调用明细:#1 模型调用 (8.52s) → TodoWrite (5ms), Read invoice.ts (14ms) → #2 模型调用 (3.27s) → Read invoice.test.ts (22ms) → #3 模型调用 (4.04s) → Execute git status (218ms) → #4 模型调用 (3.42s) → Read tax.ts (14ms) → #5 模型调用 (3.55s) → Read money.ts (20ms) → #6 模型调用 (3.57s) → TodoWrite (5ms), ApplyPatch invoice.test.ts (1.05s) → #7 模型调用 (3.42s) → TodoWrite (6ms), Execute vitest run (3.59s) → #8 模型调用 (4.73s) → Execute eslint (7.94s), Execute prettier —check (432ms) → #9 模型调用 (5.49s) → Execute git diff —check (120ms), Execute git status (271ms) → #10 模型调用 (2.33s) → TodoWrite (7ms) 并输出最终回答。
- 脚本工具(Script Tool):每次模型调用编写一段脚本,批量运行工具调用并返回单一汇总结果。相同的 15 次工具调用仅需 5 次模型调用,模型推理耗时降至 28.0 秒,总耗时缩短至 41.6 秒(提速 15.2 秒)。
- 调用明细:#1 模型调用 (8.64s) → 单次 Script (421ms,并发执行 TodoWrite、读取 4 个源码文件及 git status) → #2 模型调用 (5.35s) → 单次 Script (1.25s,执行 TodoWrite 与 ApplyPatch) → #3 模型调用 (3.36s) → 单次 Script (3.78s,执行 TodoWrite 与 vitest run) → #4 模型调用 (8.42s) → 单次 Script (8.14s,执行 eslint、prettier、git diff、git status) → #5 模型调用 (2.27s) → TodoWrite (7ms) 并输出最终回答。
由于这些调用本身就是代码,前一步的结果可以直接决定下一步的调用逻辑。例如,程序可以在单次遍历中完成搜索、读取所有匹配项并过滤结果;若采用直接调用,每一个步骤都必须消耗一次模型请求。
与直接工具调用相比,Script 模式在 Claude Opus 5.5 上将 Droid 的成本降低了 15%。大多数 Script 体积很小,单任务的成本节省主要集中在包含 6 次及以上工具调用的长尾脚本中(占全部脚本的 12.5%)。
来自我们内部真实会话的两个长尾案例(已做简化与脱敏处理)直观展示了这种威力。在每个案例中,Script 与直接调用执行了完全相同的工具操作,核心差异在于消耗的模型请求次数:
- Linear 工单清理任务:将 151 个已批准的工单在不同队列间迁移,并逐一验证每次迁移是否仅修改了状态字段,共计 312 次工具调用。若采用直接调用,每次请求都要重发约 28,000 Token 的固定指令与不断膨胀的历史记录;即便每次请求塞入 10 次调用,也需要 36 次模型请求(若每次请求 3 次调用则需 107 次请求),累计读取约 310 万输入 Token。而使用 Script 仅消耗了 2 次模型请求和约 61,000 Token:第一次请求编写程序,第二次请求读取程序打印的 6 行汇总输出。
- CI 批量巡检任务:跨 547 次运行检查了 5,384 个桌面端构建任务,总计 550 次工具调用(每次并发 60 个)。Script 仅用 2 次请求便完成了预计需要 59 至 187 次直接请求的工作。模型最终只看到了一份包含 41 个失败任务在内的五项数字摘要,进入模型上下文的数据量不到原始工具结果的 0.1%。该巡检脚本在后台运行了约 8 分钟,期间模型可以同时处理其他任务。
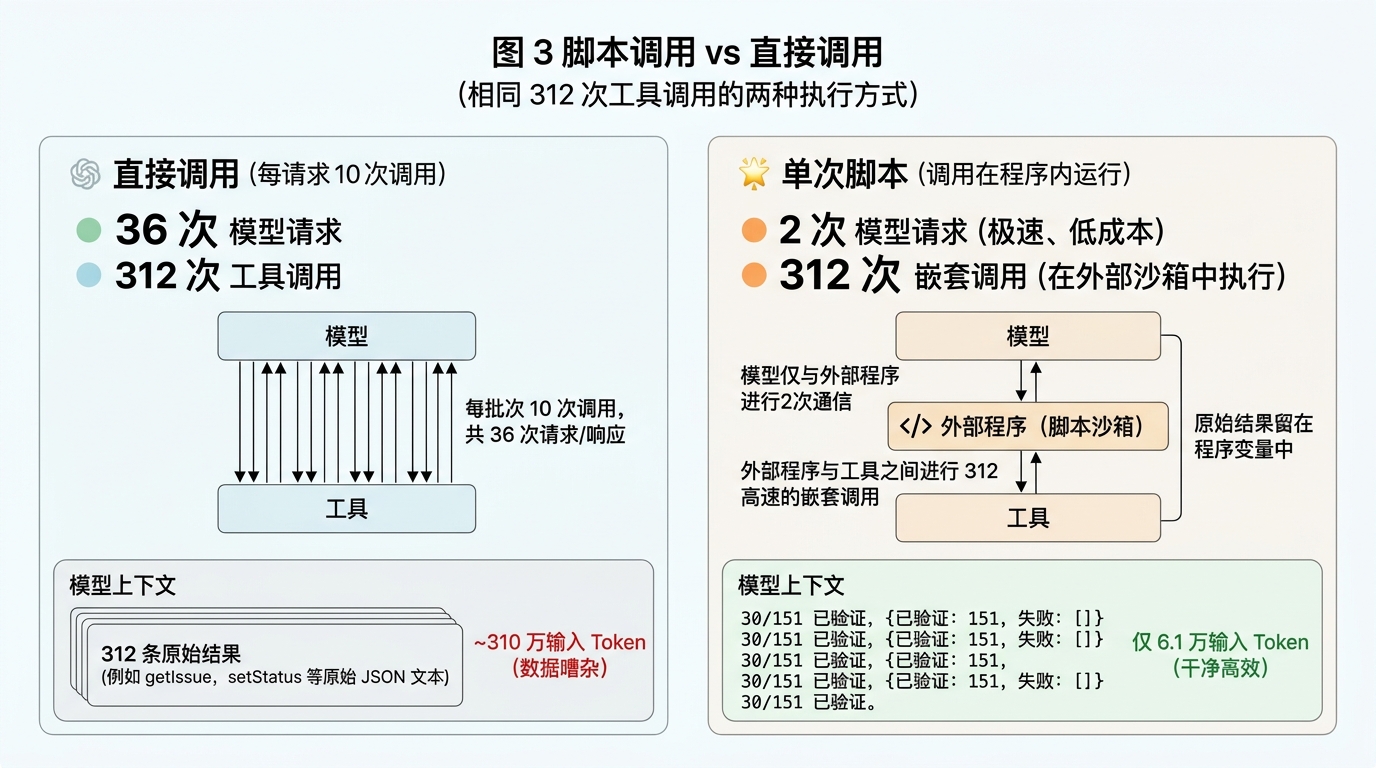
图 3:相同 312 次工具调用的两种执行方式对比
以下为 Linear 工单清理任务中由模型在请求 1 中编写的真实简化脚本(通过 text() 函数向模型上下文打印精简结果):
const remaining = new Set(readReport('<report>').notAttempted) // 151 个待处理工单
// 并行读取两个队列const queues = await Promise.all([listAll('Triage'), listAll('<queue 2>')])const targets = queues.flat().filter((i) => remaining.has(i.id))
const verified = [], failures = []for (const batch of chunks(targets, 3)) { // 每次并发处理 3 个工单  await Promise.allSettled(batch.map((i) => setStatus(i, 'Backlog')))  const after = await Promise.allSettled(batch.map((i) => getIssue(i)))  after.forEach((r, n) =>    (onlyStatusChanged(batch[n], r.value) ? verified : failures).push(batch[n].id))  if (failures.length) break // 一旦出现预期之外的字段变更立即中止  if (verified.length % 30 === 0) text(`${verified.length} of 151 verified`)}
writeResult('<result file>', { verified, failures })text({ verified: verified.length, failures })
2.2 它是如何提升质量的
- 更干净的上下文:原始文件内容、搜索结果和运行日志都保留在程序内部,模型在推理时受到的噪声干扰大幅减少。
- 循环与工作流确定性运行:在上述 Linear 清理任务中,脚本在每次写入前后精准比对了 15 个字段,维护了精确计数,并被设定为一旦发现任何其他字段发生改变就立即停止。
- 规划前置:模型在推理阶段就推演出完整序列,编写出的程序本身就是执行计划。能力越强的模型规划得越远,其编写的 Script 也越复杂,单次请求内完成的工作量就越大。
前沿模型已经能从程序化工具调用中获得巨大收益,且随着基座模型能力的演进,这种增益还将持续扩大。目前,Script 模式已在 GPT-6.1 Sol、GPT-6.1 Terra、GPT-6 Astra、GPT-6 Sol、GPT-5.6 Sol、Claude Fable 5.1、Claude Fable 5、Claude Opus 5.5、Claude Opus 5 以及 Kimi K3 上默认开启。
2.3 关键设计抉择
程序化工具调用看似容易接入,实则极易踩坑。以下是起决定性作用的五项核心设计抉择:
| 设计抉择 | 工作机制 | 核心价值 |
|---|---|---|
| 程序获取真实结构化数据 | 直接向程序提供完整文件以及结构化、强类型的搜索结果。 | 过滤和统计在代码中直接完成,零 Token 消耗。 |
| 字面量文本原样传输 | 文件内容、代码补丁(Patch)和终端命令放入原始输入块传输,无需转义字符串。 | 消耗更少 Token,大幅减少格式错误的调用。 |
| 编辑操作返回简短摘要 | 程序内部的文件编辑与直接编辑一样,仅返回简短摘要。 | 避免将修改后的完整文件重新粘贴回上下文。 |
| 绝不被长耗时任务阻塞 | 程序最长等待 5 分钟,随后交还目前已产生的输出;也可直接在后台启动并立即返回。 | 模型可以继续推进其他工作,不发生阻塞。 |
| 零轮询消耗 (No Polling) | 专用工具负责检查、等待或终止运行中的程序;后台任务完成时由 Droid 主动唤醒模型。 | 不会浪费任何模型请求去反复询问“任务跑完没有”。 |
03 智能体工厂 (The Agent Factory)
Script 模式的诞生,以及针对不同模型决定是否启用该模式的策略,均产自同一个自动化演进闭环(Droid 的绝大多数改进皆出于此)。新模型和新快照每隔几周就会涌现,没有任何人类工程团队能靠手工调优跟上所有模型的迭代节奏。
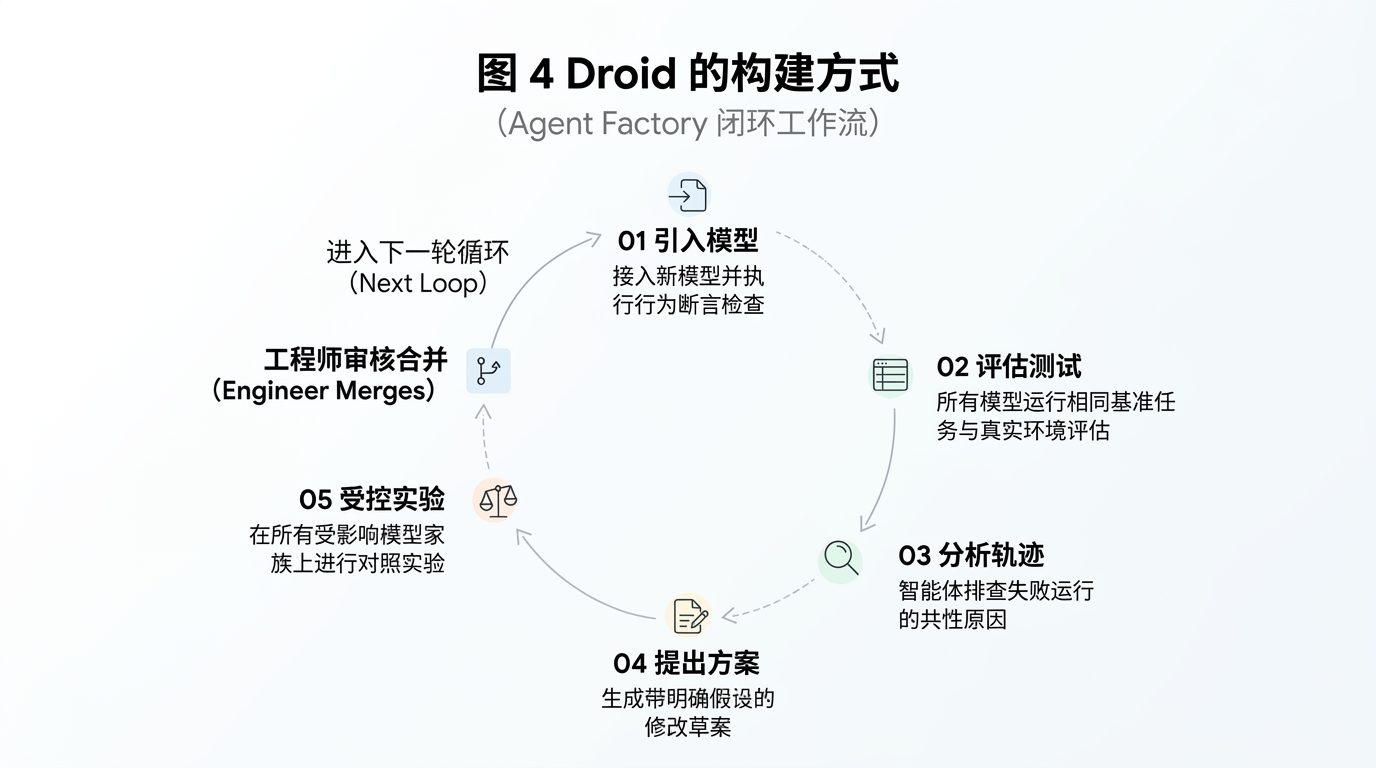
图 4:Droid 的构建方式(Agent Factory 五步闭环)
- 01 引入模型(Bring In):将新模型接入 Droid 并执行基础行为断言检查。
- 02 评估测试(Evaluate):所有模型运行相同的基准任务与真实生产环境评估。
- 03 分析轨迹(Read Traces):智能体自动排查失败运行记录背后的共性原因。
- 04 提出方案(Propose):生成带有明确假设的修改草案。
- 05 受控实验(Test):在所有受影响的模型家族上开展对照实验,最后由工程师审查合并,改进后的 Droid 随即接管下一轮循环。
当某个新模型首次可用(通常是早期预览快照)时,这套跟踪超过 20 款模型的自动化系统就会启动,将其接入 Droid 并运行行为断言检查。通过断言只是最低门槛,远非发布标准。此后,每款可用模型都会通过产品本身接受全方位评估:涵盖实时生产环境、QA 质量测试以及每日基准测试。实时错误日志和用户在真实会话中遭遇的摩擦点会被汇总到各模型的评估结果中,使负责审查的智能体能够并排对比基准测试失败与真实用户会话。
单次失败说明不了太多问题,因此智能体会重点寻找跨任务、跨模型重复出现的共性根因。它将每项发现转化为一份阐明假设的改进提案,并通过受控实验在涉及的每一款模型上量化测试该改动的效果。
由于绝大多数改动由智能体编写,提出提案的智能体与负责审查的人类工程师必须对“什么是好改动”持有完全一致的标准。每一轮交互都会重新发送整个请求,因此一句位置不当的指令或一条过时的工具输出绝不只造成一次伤害,它会在后续每一轮交互中持续分散模型注意力,损耗输出质量、Token 预算和响应时间。所有提案都必须严格遵循以下五项基本原则:
- 精打细算每一个 Token,将庞大的工具输出结果保存在文件中。
- 以仅追加(Append-Only)方式增长请求,始终维持提示词缓存(Prompt Cache)有效。
- 剖析推理热路径(Hot Path),缓存一切可以缓存的内容。
- 跟踪后台工作(如长耗时命令和子智能体),并在任务完成时主动唤醒模型。
- 当智能体陷入停滞时,始终备有明确的下一步动作:轻推提醒(Nudge)、重试(Retry)、摘要压缩(Summarize)或终止(Stop)。
Droid 提出的改进方案取决于其优化的目标,且有一项硬性要求:每项目标必须在所有模型家族上同时成立。例如,当我们在 GPT-6.1 Sol、Claude Opus 5.5、GLM 5.3 和 Kimi K3 上调优 Script 模式时,目标之一是“当同时提供 Script 和直接工具时,模型应主动优先选择 Script”。闭环系统为此生成了三项改动:调整系统提示词、修改 Script 内部所调用工具的描述、优化 Script 返回结果的结构。没有任何单项改动能在所有模型上单独奏效,但三者结合后,所有模型都达成了目标。
另一个目标是让 Script 模式在所有模型家族上的成本均低于直接调用。在读取文件时为每一行添加行号,成功阻止了 GPT-6.1 Sol 为了获取行号而通过 Shell 重复读取文件的行为,并在某项任务上将 Claude Opus 的成本降低了 22%;但这同时也会在每次读取时每行增加约 2 个 Token,导致原本就没有重复读取问题的 GLM 成本上升 8%、Kimi 成本上升 32%。最终,该功能被设计为一个可选参数,仅当模型确实需要行号时才主动请求开启。
人类工程师坐镇闭环的最后一环。他们审阅每份提案及其实验数据,对照核心原则进行核验,并拍板决定哪些改动上线。这使得我们的工具链始终能与各大模型厂商的演进保持同步。
04 超越程序化工具调用的全链路优化
程序化工具调用是演进闭环产出的最大变革,但绝非唯一一项。其余改进颗粒度更细,遍布整个工具链:模型服务商能复用多少请求前缀、每次请求具体包含什么内容、当某一轮交互出错时主循环如何恢复,以及每次请求能以多快的速度发往模型。
4.1 保持提示词缓存温热 (Keeping the Prompt Cache Warm)
模型服务商按前缀(Prefix)缓存请求,因此前缀中的任何一处改动都会使该位置之后的所有缓存全部失效。Droid 的请求原本就已经是仅追加(Append-Only)结构,但有一个例外:工具动态发现(Tool Discovery)。工具定义通常位于请求的最顶部,因此在会话中途加载 MCP 工具或连接器工具,意味着必须将整段对话历史全部重新处理一遍。现在,Droid 会将新发现的工具直接追加到请求的末尾,从而让已缓存的前缀保持原封不动。
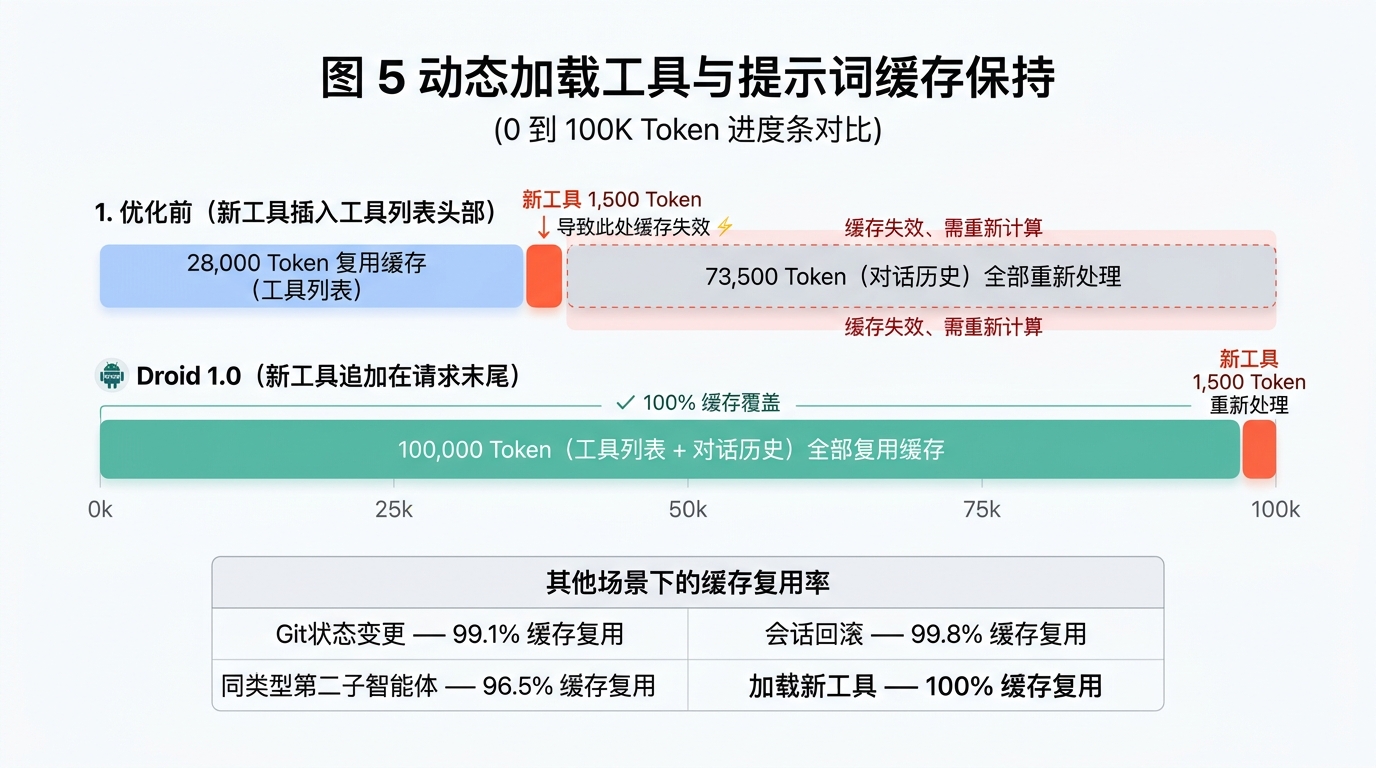
图 5:会话中途加载新工具及各类变更的缓存复用率实测
| 会话中途发生的变更 | 下一次请求的缓存读取比例 |
|---|---|
| Git 状态变更(测试环境实测:复用 19,976 Token,仅新增 176 Token) | 99.1% |
| 会话回滚 (Session Rolled Back)(测试环境实测) | 99.8% |
| 启动同类型的第二个子智能体(测试环境实测) | 96.5% |
| 动态加载新工具(Azure 前后对比实测:全部 26,400 Token 100% 复用) | 100% |
在生产环境中,典型请求有 98% 的输入直接读取自缓存,且 98.6% 的请求严格符合仅追加规则。一套专门的监控程序会逐一比对每次请求与前一次请求的差异,精准标记任何破坏缓存的字段。缓存失效的代价极其高昂:请求前部的单个 Token 变动就会迫使全量上下文重新计算。这类问题正是 Agent Factory 的最佳用武之地,它已陆续交付了多项提示词缓存修复:Git 状态变更后,下一次请求仅增加 176 个新 Token;会话回滚可复用 99.8% 的缓存;同类型的第二个子智能体可复用 96.5% 的缓存。遇到报错也不会重置缓存,因为 Droid 会在已持有该缓存的模型服务商节点上直接重试失败的请求。
4.2 将基础提示词精简 37%
会话的第一轮请求携带了系统指令、工具定义和启动上下文,这些内容会伴随此后每一轮交互一路传递,因此也是我们动刀最狠的部分。在 Droid 0.170.0 到 0.250.0 版本之间,首轮请求的输入从 20,887 Token 缩减至 13,055 Token(降幅达 37%)。
绝大多数节省来自工具定义。Droid 过去在启动时会一次性发送 11 个工具定义;现在初始仅发送 2 个,低频使用的工具会在模型需要时按需动态加载。工具定义体积由此下降了 46%,Droid 在启动时附加的提醒信息也缩减了近三分之一(32%)。相反,系统提示词(System Prompt)本身增长了 33%(尽管旧提示词中的大部分规则都已被精简压缩)。增长的部分来自两个领域的新增引导:智能体如何与用户沟通,以及如何处理图像、已连接应用和个人数据等环境细节。
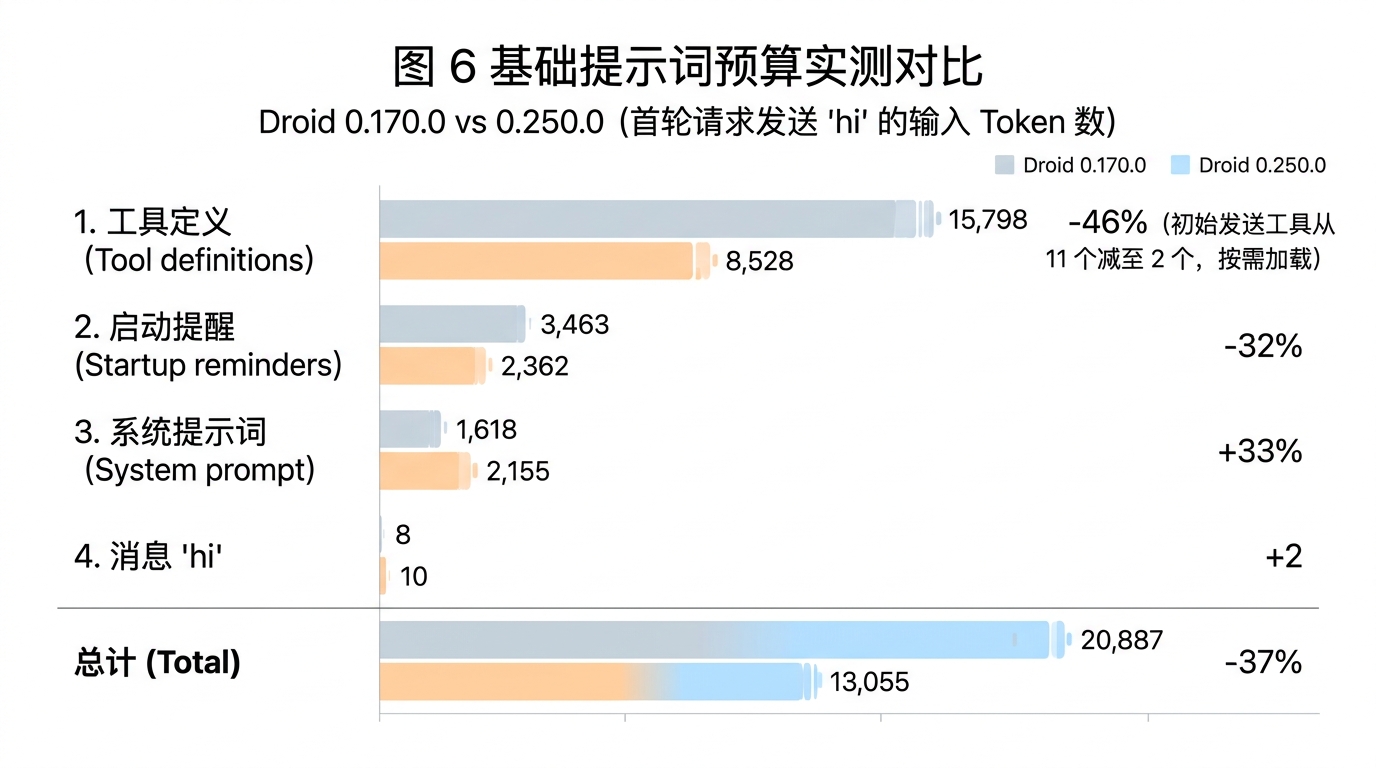
图 6:会话首轮请求(用户输入“hi”)的提示词预算对比(0.170.0 基于 Opus 4.8 vs 0.250.0 基于 Opus 5.5) 注:由于两个版本运行在不同模型上,分词器(Tokenizer)略有差异;若按不依赖分词器的字符数统计,请求体积从 57,035 字符降至 36,802 字符(缩减 35%)。
大量的提示词重写工作是由模型自己完成的。一套自动化流程会定期将 Droid 的系统指令交给模型,要求它找出其中重复、自相矛盾或表述含糊的指导规则。每一项发现都会转化为一条修改提案,像其他代码改动一样接受严格的实验测试。
4.3 有界自主性 (Bounded Autonomy)
智能体独立运行的时间越长,陷入死胡同、重复无效劳动或彻底偏离任务的可能性就越多。Droid 能够精准检测上述每一种异常状态,并为每种情况配备了明确的下一步动作:轻推提醒(Nudge)、重试(Retry)或终止(Stop)。这些控制规则构建在工具链主循环中,而非依赖模型自身,因此对 Droid 支持的所有模型服务商均统一生效,任何新接入的模型在第一天(Day 0)就能自动获得这些保障。
- 卡死检测(Getting Stuck):通常体现在流式输出中断上。在 Factory 托管的 Anthropic 数据流上,连续 4 分钟无响应即被判定为断流并触发重试。触及硬性超时上限的响应最多可获得两次重试机会;半途中断的残缺响应会在重试前被彻底清除,确保模型始终只在完整回答的基础上继续构建。
- 重复劳动拦截(Repeated Work):通过计数机制捕获。连续 3 轮没有任何可见输出,Droid 会直接停止;连续 3 次完全相同的工具调用会触发一次轻推提醒,达到 6 次则强制终止循环。但如果重复调用返回了新结果(例如轮询构建进度),则允许继续执行。
- 防止遗忘任务(Dropping the Task):任务丢失最常发生在长对话被摘要压缩(Compaction Summary)的时候。我们将这类压缩摘要的容量上限从 8,000 Token 翻倍至 16,000 Token,因为据我们测算,此前有三分之一甚至更多的长会话摘要已经撑满了旧上限。
- 后台休眠与唤醒:并非所有长时间等待都是故障。当模型启动一项耗时任务(如子智能体或长时间运行的终端命令)时,它可以将该任务移交后台并进入休眠状态。待后台任务执行完毕,Droid 会携带一条提醒主动唤醒模型。
4.4 剖析推理热路径 (Profiling the Hot Path)
当请求完成缓存优化与体积瘦身后,模型自身的推理耗时基本不在我们的控制范围内,但我们能以多快的速度把请求送到模型手上则完全取决于工程实现。此前,Droid 在每一轮交互时都会重新构建已连接应用列表,且随着会话历史变长,请求前的工具预检查找(Pre-flight Tool Lookups)也会越来越慢。
第一轮交互的额外开销尤为显著:登录校验存在重复工作且串行执行;启动请求必须等待 Droid 的全部代码加载完毕;第一次模型请求还要等待所有 MCP 服务器完成初始化;使用自有 Amazon Bedrock 凭证的用户在凭证加载期间还会面临额外的延迟。
在最新更新中,上述所有等待均已被彻底消除或移出关键路径:
- 连接应用列表缓存:Droid 会复用已连接应用列表直至连接状态发生改变,将单轮准备时间压缩至 24 ms。在受控测试中,仅此一项改动就让响应完成时间的中位数提前了 13%。
- 增量历史检索:Droid 现在只读取会话历史中最新鲜的部分,使请求前的工具预检查找耗时降至约 1 ms。
- 并行登录校验:登录检查改为无重复并行执行,中位耗时从 101 ms 降至 59 ms。
- 请求与代码加载并发:
droid exec在代码仍在加载时就同步并发发送身份验证、功能开关(Feature-flag)、组织策略和连接器请求,将首次模型请求前的准备时间中位数从 1,741 ms 大幅削减至 646 ms。 - 异步启动 MCP 与凭证预热:MCP 服务器与第一轮交互并行启动(初始化耗时 3 秒的服务器不再阻塞首轮请求),Bedrock 凭证也在首次请求前准备就绪。
- 推理代理路由优化:在用户机器之外,我们修复了推理代理层的一项路由开销,为每一次模型调用直接削减了 150 ms 延迟。
这些优化在真实生产环境的智能体交互中立竿见影:从用户按下回车键(Enter)到发出模型请求,Droid 仅耗时 124 ms(其中 97 ms 用于收集上下文,27 ms 用于构建请求)。这意味着用户在等待首字输出(TTFT)时,97% 的等待时间完全取决于模型自身的推理计算。
4.5 从启动那一刻起就快如闪电
在智能体循环之外,Droid 1.0 还大幅削减了用户在客户端应用本身感受到的延迟:打开应用、启动会话、同时运行多个会话以及退出应用。
- 首屏渲染提速 3.8 倍:中位耗时从 1,839 ms 降至 488 ms
- 可输入首条提示词提速 3.0 倍:中位耗时从 1,876 ms 降至 618 ms
- 极速退出仅需 30 ms:生产环境中位退出耗时从 648 ms 降至 30 ms
打开应用是每次会话的第一道等待。在 8 月 25 日至 10 月 20 日发布的版本间,首屏渲染(First Paint)中位时间从 1,839 ms 降至 488 ms,直到 Droid 能够接收用户输入提示词的时间从 1,876 ms 降至 618 ms,降幅均接近 70%。这主要归功于减少了首帧渲染前的工作量:Droid 现在直接分发预编译代码,启动时不再需要实时解析约 6,000 个模块;在启动收尾阶段即可实时响应键盘输入,且一旦任何代码改动导致首次按键响应的 P95 延迟超过 250 ms,CI 流水线就会直接报错拦截。升级至 Bun 1.4.2 使 Linux、macOS 和 Windows 平台上的 P95 启动时间缩短了 13% 至 22%;针对 Windows 平台,Droid 还跳过了繁琐的控制台初始化设置,并缓存了系统证书列表。
远程机器上的会话运行在守护进程(Daemon)中,必须等守护进程就绪才能启动。过去,守护进程会先等待登录 Shell、证书、区域设置(Locales)和技能包(Skills)全部加载完毕;现在这些组件全部改为即时按需加载(Just-in-time)。在开发者的 Mac 上,从启动到就绪的中位时间从 1,956 ms 降至 392 ms(在空 Shell 配置下则从 887 ms 降至 376 ms)。
最深层的变革来自架构层面。过去,同时运行多个会话意味着启动多个独立进程,每个进程占用约 350 MB 内存,因此开启 5 个并行子智能体加上主会话就会消耗超过 2 GB 内存。现在,所有会话共享同一个守护进程,每新增一个会话仅增加约 20 MB 内存开销,执行 /new 新建会话几乎是瞬间完成。
退出应用是最后一道等待,过去它受制于网络请求。现在,Droid 会将尚未发送完毕的遥测数据和会话同步任务移交给一个独立的后台分离进程(Detached Process),主进程立即退出。生产环境中的退出时间中位数由此从 648 ms 骤降至 30 ms。
05 前所未有的执行速度
节省 Token 的改动同样能节省时间:Script 模式发起了更少的模型请求,而剩下的每一次请求体积更小且绝大部分命中缓存。在 Claude Opus 5.5 上,Droid 完成单个通过任务的耗时比 Claude Code 少 26%,消耗的 Token 少 17%。在 GPT-6.1 Sol 上,它的 Token 消耗比 Codex 少 12%,耗时则长 10%。
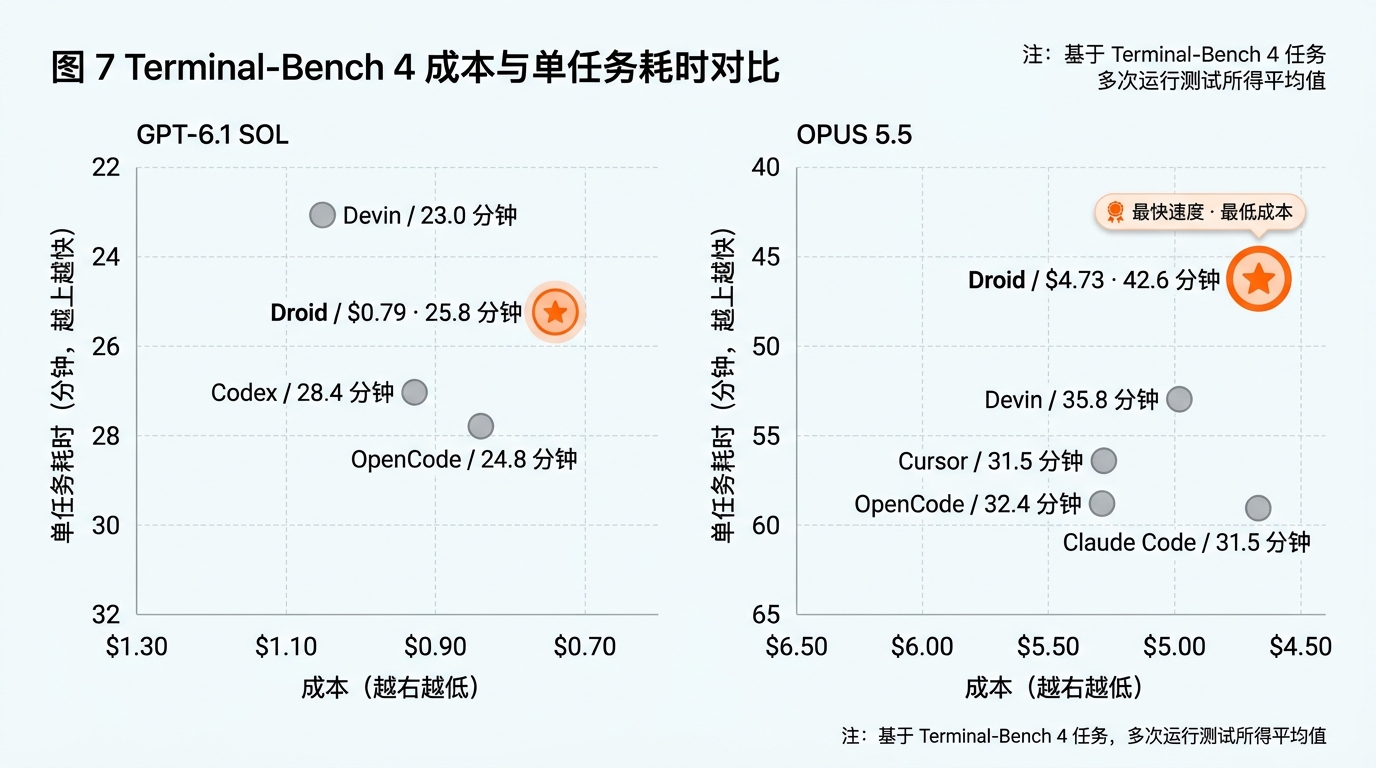
图 7:Terminal-Bench 4 单任务成本与耗时对比
- Claude Opus 5.5:Droid 平均单任务耗时 42.6 分钟(成本 $4.73),比所有其他受测工具链快 16% 至 26%(比 Cursor 和 Claude Code 快 26%,比 OpenCode 快 24%,比 Devin 快 16%)。
- GPT-6.1 Sol:Droid 平均单任务耗时 25.8 分钟(成本 $0.79),在成本比 Codex 低 12% 的前提下耗时增加 10%,同时比 OpenCode 快 4%、比 Devin 快 11%。
上述耗时仅统计了任务执行本身。而在每个任务之外,Droid 打开应用、启动会话和退出的时间仅为今年 8 月份的一小部分,因此开启新会话或在多个会话间切换几乎零成本。